왜 만들었나요
지원자 이력서 PDF를 스무 개 넘게 받아 이름과 경력만 표로 옮기려는데, 파일을 하나씩 열어 글자를 긁는 데만 한참 걸렸습니다. 그래서 한꺼번에 올리면 글자가 알아서 뽑혀 나오게 만들었습니다.
PDF 안의 글자를 페이지 순서대로 뽑아 복사하거나 TXT 파일로 저장합니다. 여러 개를 한꺼번에 올리면 파일별로 따로 정리되고, 글자가 거의 없는 PDF는 자동으로 글자 인식(OCR)으로 넘어갑니다.
또는 파일을 여기에 끌어다 놓으세요
PDF · 최대 10개 · 개당 100MB
지원자 이력서 PDF를 스무 개 넘게 받아 이름과 경력만 표로 옮기려는데, 파일을 하나씩 열어 글자를 긁는 데만 한참 걸렸습니다. 그래서 한꺼번에 올리면 글자가 알아서 뽑혀 나오게 만들었습니다.
참고
올린 PDF는 서버로 전송되지 않습니다. 추출도 글자 인식도 전부 브라우저 안에서 이뤄져, 이력서·계약서처럼 개인정보가 담긴 문서도 기기 밖으로 나가지 않습니다.
PDF를 드래그하거나 클릭해서 올립니다.
올리는 즉시 자동으로 추출이 시작됩니다. 위쪽에는 올린 파일들의 첫 페이지 미리보기가 늘어서고, 아래쪽에는 고른 파일의 텍스트가 페이지 순서대로 표시됩니다. 위쪽에서 다른 파일을 누르면 아래 결과도 그 파일로 바뀝니다. 진행 중에는 텍스트 추출 중 · 3/12 페이지처럼 진행 막대가 함께 보이고, 스캔본이면 스캔본 감지가 뜬 뒤 스캔본 글자 인식 중 · 3/12 페이지 · 40% 같은 진행 상황이 이어서 표시됩니다. 실패한 파일에는 다시 시도 버튼이 붙습니다. 결과는 3페이지 같은 구분선으로 나뉩니다.
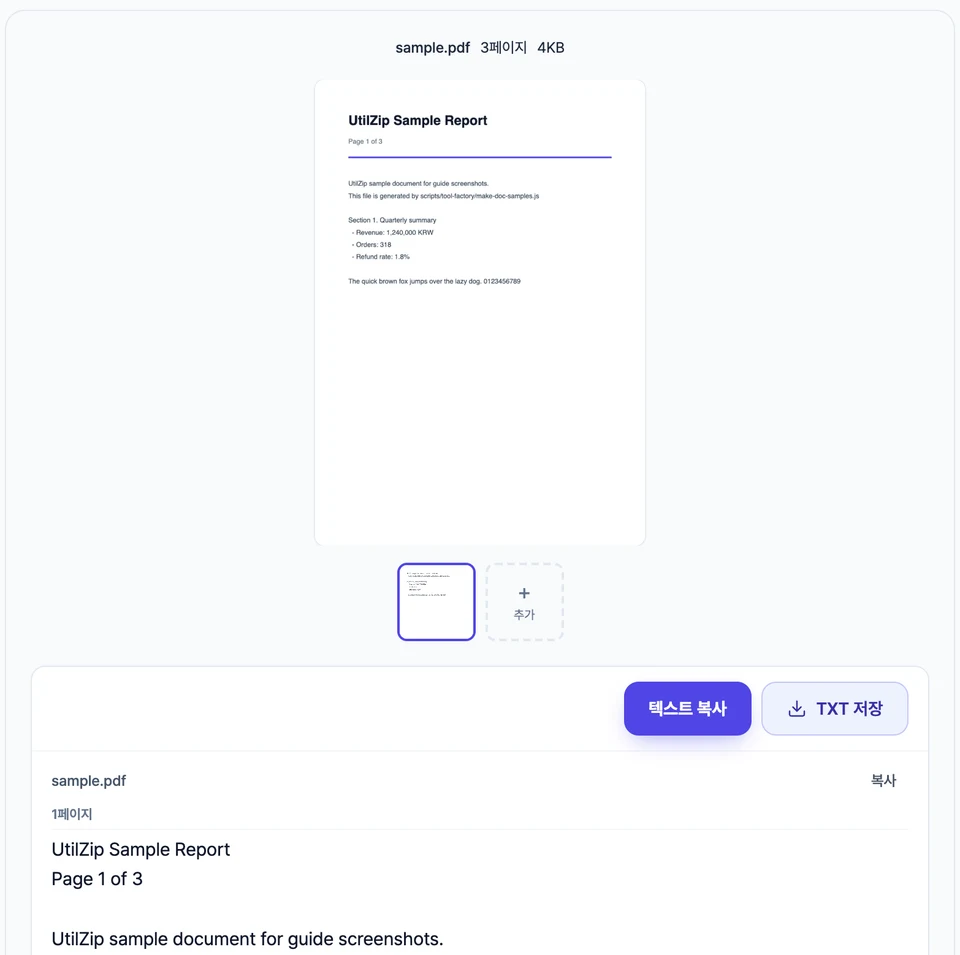
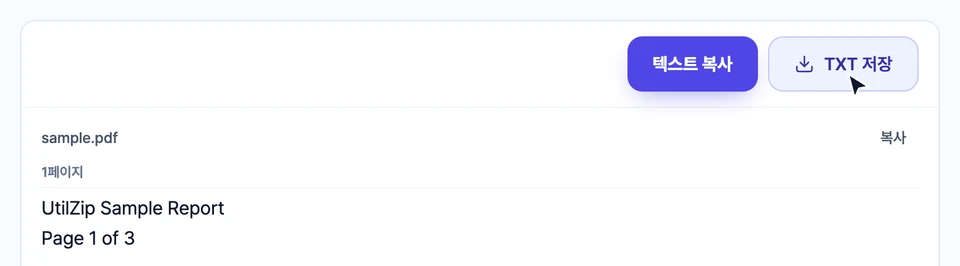
한 파일만 가져가려면 아래 텍스트 칸의 파일 이름 옆 복사를 누릅니다. 모든 파일이 끝나면 텍스트 칸 위쪽의 텍스트 복사·TXT 저장이 켜집니다. 성공한 파일이 2개 이상이면 단추가 전체 텍스트 복사·전체 TXT 저장으로 바뀌고, 저장하면 ZIP 파일 하나로 받습니다.
파일 목록 다루기 — 썸네일 줄 끝의 + 추가로 파일을 더 넣고, 썸네일 오른쪽 위의 ✕를 눌러 하나씩 뺍니다(PC에서는 썸네일에 마우스를 올리면 보입니다).
이력서 PDF 3개를 올리면 이렇게 나옵니다.
| 넣은 것 | 나온 것 |
|---|---|
이력서_A.pdf이력서_B.pdf이력서_C.pdf | 추출-텍스트.zip — 파일별 TXT 3개 |
성공한 결과가 하나면 ZIP 없이 원본 이름 그대로 TXT 하나(이력서_A.txt)로 내려받습니다. 화면에서 바로 복사 버튼으로 가져갈 수도 있습니다.
| 종류 | 어떻게 만들어졌나 | 이 도구의 처리 |
|---|---|---|
| 글자 PDF | 워드·한글에서 바로 저장 | 글자를 그대로 꺼냅니다 (빠르고 정확) |
| 스캔본 | 종이를 스캔하거나 사진으로 찍음 | 글자 인식으로 전환 |
어느 쪽인지 자동으로 판단합니다. 기준은 하나입니다 — 문서 전체에서 뽑힌 글자가 공백을 뺀 10자 미만이면 스캔본으로 보고 글자 인식으로 넘어갑니다. 스캔본이면 파일 이름 옆에 스캔본 표시가 붙고, 처리 시간이 조금 더 걸립니다.
판정 기준이 문서 전체라서, 머리말·워터마크처럼 글자가 10자만 있어도 스캔본으로 판정되지 않습니다. 이때는 그 몇 글자만 나오고 본문은 빠집니다. 글자 페이지와 스캔 페이지가 섞인 PDF도 마찬가지입니다.
내 PDF가 어느 쪽인지 궁금하다면, PDF 뷰어에서 글자를 마우스로 끌어 선택되는지 보면 됩니다. 선택되면 글자 PDF입니다.
PDF 안의 글자를 다시 타이핑하고 있다면 이 도구가 그 일을 대신합니다.
| 상황 | 이유 |
|---|---|
| 보고서 내용을 문서로 옮기기 | 다시 타이핑할 필요가 없습니다 |
| 여러 이력서에서 정보 찾기 | 한꺼번에 뽑아 검색 |
| 스캔한 서류의 내용 정리 | 종이 문서를 글자로 |
| 계약서 문구 인용 | 필요한 문장만 복사 |
한 번에 10개까지, 파일당 100MB까지 올릴 수 있습니다. 여러 개를 올리면 하나씩 순서대로 처리되고, 끝난 파일부터 결과가 채워집니다.
종이를 스캔한 PDF는 글자가 아니라 사진으로 담겨 있어 그냥은 뽑히지 않습니다. 이 도구는 그런 파일을 자동으로 알아채고 글자 인식으로 전환하며, 파일 이름 옆에 스캔본 표시가 붙습니다.
| 조건 | 정확도 |
|---|---|
| 반듯하게 스캔한 인쇄물 | 높습니다 |
| 비뚤어지거나 그림자 진 사진 | 떨어집니다 |
| 손글씨 | 많이 떨어집니다 |
| 흐릿하거나 작은 글자 | 빠지거나 틀립니다 |
한국어와 영어를 인식하며, 첫 사용 때는 인식 데이터를 내려받느라 잠시 준비 시간이 걸립니다.
머리말·워터마크·페이지 번호처럼 글자가 10자만 들어 있어도 스캔본으로 판정되지 않아 글자 인식으로 넘어가지 않습니다. 글자 인식을 직접 켜는 단추는 없습니다. 이럴 때는 PDF JPG 변환으로 페이지를 이미지로 바꾼 뒤 이미지 텍스트 추출에 넣으면 글자 인식을 거칠 수 있습니다.
같은 '이상하다'도 원인이 제각각입니다. 증상을 먼저 확인하면 해결 방법이 정해집니다.
| 증상 | 원인 | 해결 |
|---|---|---|
| 줄 순서가 뒤섞임 | 같은 높이의 글자를 한 줄로 묶어 읽기 때문에 2단 문서는 좌우 단이 한 줄에 섞임 | 뽑아낸 뒤 직접 정리 |
| 글자가 아예 안 나옴 | 스캔 화질이 너무 낮음 | 더 선명하게 다시 스캔 |
| 글자가 군데군데 틀림 | 스캔본 인식의 한계 | 원본이 있다면 원본에서 추출 |
| 글자 사이가 띄어져 나옴 | PDF가 글자를 조각조각 저장해 조각 사이에 띄어쓰기가 들어감 | 뽑은 뒤 직접 다듬기 |
올라가지 않거나 오류가 뜨면 아래를 확인해 보세요.
| 확인할 것 | 기준 |
|---|---|
| 형식 | PDF만 |
| 크기 | 한 개당 100MB까지 |
| 개수 | 한 번에 10개까지 |
| 암호 | 암호가 걸린 PDF는 불가 |
PDF 안에 글자가 글자로 저장된 부분입니다. 워드나 한글에서 만든 PDF에는 이게 들어 있어 그대로 복사됩니다. 종이를 스캔한 PDF에는 없습니다.
사진 속 글자 모양을 보고 어떤 글자인지 알아맞히는 기술입니다. 텍스트 레이어가 없는 스캔본에서 글자를 꺼낼 때 씁니다. 사람이 읽듯 추측하는 방식이라 100% 정확하지는 않습니다.
네. 스캔본은 글자가 아니라 사진으로 저장돼 있어 뽑아낼 텍스트가 없는데, 이 도구는 그런 파일을 자동으로 알아채고 글자 인식(OCR)으로 처리합니다. 이때 파일 이름 옆에 '스캔본' 표시가 붙습니다. 한국어와 영어를 인식하며, 인쇄물을 반듯하게 스캔한 문서일수록 정확도가 높습니다. 손글씨나 해상도가 낮은 사진은 글자가 일부 빠지거나 틀리게 나올 수 있습니다.
PDF에 기록된 글자 위치를 기준으로 줄을 다시 맞춰 뽑기 때문에 일반적인 문서는 대체로 읽는 순서대로 나옵니다. 다만 표는 칸 구분 없이 띄어쓰기로만 이어져 나오고, 2단으로 편집된 문서는 같은 높이의 좌우 단이 한 줄에 섞여 순서가 어긋날 수 있습니다. 머리말이나 쪽 번호도 본문과 함께 섞입니다. 표는 뽑은 뒤 칸을 직접 나눠야 합니다. PDF가 글자를 조각조각 저장해 둔 경우에는 조각 사이에 띄어쓰기가 들어가 글자 사이가 벌어져 나올 수 있으니, 뽑은 뒤 직접 다듬어 주세요.
네. 한 번에 10개까지, 파일당 100MB까지 올릴 수 있습니다. 여러 개를 올리면 하나씩 순서대로 처리되고 끝난 파일부터 결과가 채워집니다. 모든 파일 처리가 끝나면 '전체 TXT 저장'으로 추출-텍스트.zip 하나를 받고, ZIP 안에 파일마다 TXT가 하나씩 들어 있습니다. 한 파일만 필요하면 그 파일을 고르고 '복사'를 누르세요. 성공한 파일이 하나뿐이면 ZIP 없이 원본 이름 그대로 TXT 한 개로 내려받습니다.
네. 복사 버튼을 누르면 해당 파일의 전체 텍스트가 클립보드에 담겨 워드나 메모장에 바로 붙여넣을 수 있습니다. 파일로 남겨야 한다면 TXT 저장을 쓰세요. 문장 몇 개만 인용할 때는 복사가, 문서 전체를 옮겨 편집할 때는 TXT 저장이 편합니다.
PDF 뷰어에서 글자를 마우스로 끌어 선택되는지 보면 됩니다. 파랗게 선택되면 글자가 그대로 들어 있는 PDF이고, 아무리 끌어도 선택되지 않으면 종이를 스캔하거나 사진으로 찍어 만든 스캔본입니다. 이 도구는 어느 쪽인지 자동으로 판단하므로 사용자가 따로 고를 필요는 없습니다. 다만 스캔본은 글자 모양을 알아보는 과정을 거쳐야 해서 시간이 더 걸리고, 첫 사용 때는 인식 데이터를 내려받느라 잠시 준비 시간이 필요합니다.
안 됩니다. 암호가 걸린 PDF는 열리지 않으므로 잠금을 먼저 풀어 주세요. PDF 뷰어에서 암호를 넣어 연 뒤 인쇄 → 'PDF로 저장'을 골라 사본을 만들면 됩니다. 그 밖에 확인할 것은 파일 형식(PDF만), 크기(개당 100MB), 개수(한 번에 10개)입니다.
마지막 업데이트: